Rendre les bases de connaissance hétérogènes AI-ready
Pourquoi les RAG, les agents et les chatbots ont besoin d'un socle de connaissances fiable.
Une meilleure IA commence par de meilleures connaissances
Un RAG, un agent ou un chatbot peut faciliter l'accès à une documentation existante. Mais connecter un système d'IA à une base de connaissances ne rend pas automatiquement ces connaissances fiables.
Des missions récentes ont renforcé un constat que j'avais déjà rencontré à de nombreuses reprises au cours de mon travail en documentation technique : l'information est généralement là, même lorsqu'il n'est pas évident de savoir où elle se trouve, qui la connaît ou si tout le monde peut y accéder.
Les connaissances deviennent hétérogènes
Dans de nombreuses organisations, la documentation ne vit pas dans un environnement unique. Plusieurs espaces de travail peuvent coexister : par exemple, SharePoint et l'écosystème Microsoft 365 au sens large aux côtés de Confluence et de l'écosystème Atlassian, avec des outils supplémentaires choisis par certaines équipes ou pour répondre à des besoins métier spécifiques.
Mais le fait qu'une information soit stockée quelque part ne signifie pas qu'elle soit également visible par tous. Les droits d'accès diffèrent. Les équipes ne savent pas nécessairement ce que les autres équipes ont documenté. Certaines sources sont largement utilisées, tandis que d'autres ne sont connues que des personnes qui les ont créées.
C'est l'une des raisons pour lesquelles la documentation d'entreprise devient progressivement hétérogène.
Cette hétérogénéité est rarement conçue intentionnellement. Elle se développe généralement avec le temps : les outils s'accumulent, les auteurs changent, les pratiques documentaires évoluent, la terminologie dérive, les règles de gouvernance sont appliquées de manière inégale et l'information reste disponible longtemps après la disparition de son contexte d'origine.
La création de connaissances est collaborative
Les bases de connaissances renforcent cette dynamique d'une autre manière.
L'un de leurs principes fondamentaux consiste à rendre la création de connaissances collaborative. Product Managers, développeurs, consultants, équipes support, Data Scientists et autres experts métier peuvent tous contribuer directement.
C'est un avantage majeur.
La connaissance collaborative crée de la variation
Mais ouvrir la création de documentation à de nombreux contributeurs signifie aussi l'ouvrir à des vocabulaires, des structures, des styles rédactionnels, des niveaux de détail et des pratiques de maintenance différents.
La connaissance devient un espace d'information partagé
Dans le même temps, une base de connaissances joue le rôle de référentiel partagé des connaissances de l'entreprise. L'un de ses objectifs fondamentaux est de rendre ces connaissances internes recherchables et récupérables.
Cela en fait une candidate naturelle pour les systèmes RAG, les agents et autres interfaces alimentées par l'IA.
Comme expliqué dans Agents documentaires : 1. Définir la stratégie, la première question consiste à déterminer quel service l'agent est censé fournir. Ici, l'attention se déplace vers la qualité des connaissances sur lesquelles ce service repose.
La tentation est simple : si les utilisateurs recherchent déjà dans la base de connaissances, pourquoi ne pas laisser l'IA y chercher à leur place ?
La difficulté est que l'IA interroge le corpus tel qu'il existe réellement — avec ses lacunes, ses strates obsolètes, ses variations terminologiques, son contexte implicite et ses sources de vérité incertaines.
La qualité des connaissances conditionne la durabilité de l'IA
Un RAG ne répare pas une mauvaise documentation.
Et il ne s'agit pas seulement de la qualité initiale des réponses.
La pertinence à long terme d'un agent ou d'un système RAG dépend aussi de la qualité de la source de connaissances qu'il continue d'utiliser.
Une surface de connaissances bien conçue peut être correctement délimitée au lancement et néanmoins se dégrader avec le temps si le corpus sous-jacent évolue sans bénéficier de la même attention. De nouveaux documents apparaissent, la terminologie change, des informations obsolètes restent accessibles, les statuts de cycle de vie deviennent inexacts et de nouvelles sources sont introduites.
Comme expliqué dans Agents documentaires : 2. Penser l'architecture, définir la bonne surface de connaissances est une décision d'architecture. Mais même une surface bien délimitée peut devenir moins fiable si les connaissances qu'elle contient ne sont pas maintenues dans le temps.
Le système peut donc produire de bons résultats au départ, puis dériver progressivement vers des réponses moins cohérentes ou moins fiables — non pas parce que le modèle ou l'architecture de l'agent a nécessairement changé, mais parce que l'environnement de connaissances sous-jacent a évolué.
La fiabilité à long terme d'un service d'IA dépend en partie de la pérennité de sa source de connaissances.
Plus cette source est structurée, qualifiée et maintenue, plus le service d'IA construit au-dessus peut rester robuste dans le temps.
La documentation AI-ready commence avant le RAG.
Comprendre d'où vient l'hétérogénéité
Avant de restructurer une documentation ou de concevoir un service d'IA, il faut prendre le temps de cartographier l'environnement de connaissances existant.
Cartographier l'environnement de connaissances existant
- Quelles sources existent ?
- Qui les produit et les maintient ?
- Qui les utilise ?
- Quelle est l'histoire de la documentation ?
- Quels outils, migrations, réorganisations ou changements de pratiques l'ont façonnée ?
- Quelles parties sont activement maintenues et lesquelles sont simplement restées disponibles au fil du temps ?
- Quelles sources sont considérées comme faisant autorité, et par qui ?
Cette investigation ne doit pas se limiter aux contenus que l'on peut déjà trouver dans une base de connaissances.
Certaines connaissances peuvent ne jamais avoir été documentées.
Les rédacteurs techniques rencontrent cette situation en permanence : les entretiens avec les experts métier révèlent des hypothèses, des explications, des exceptions et des relations qui n'existent que dans la tête des personnes. Ces experts peuvent même ne pas percevoir ces éléments comme des informations manquantes, parce qu'ils comblent inconsciemment les lacunes lorsqu'ils lisent la documentation.
D'autres éléments de connaissance peuvent déjà être écrits, mais en dehors de ce que l'organisation considère officiellement comme sa documentation.
Une user story Jira peut contenir un contexte fonctionnel précieux. Un développeur peut avoir documenté une décision d'implémentation dans un dépôt ou un README. Des explications utiles peuvent rester dans des documents de travail ou des espaces d'équipe sans jamais avoir été intégrées à la base de connaissances principale.
Décloisonner les connaissances
La première tâche consiste donc en partie à décloisonner les connaissances.
Avant de réorganiser la documentation, il peut être nécessaire de rassembler ces fragments, de croiser les sources et de reconstruire une vision cohérente des connaissances autour d'un sujet donné.
Avant de restructurer la documentation, il faut parfois commencer par reconstruire la connaissance.
Les problèmes documentaires sous-jacents ne sont pas nouveaux.
Depuis des années, les rédacteurs techniques composent avec des générations successives d'outils, un versioning incohérent, des contenus dupliqués, des documents obsolètes jamais archivés, des connaissances détenues par certains contributeurs et des informations dispersées dans plusieurs systèmes.
Ce qui est nouveau, c'est la volonté de rendre ces corpus imparfaits directement exploitables par des systèmes d'IA.
La couche IA ne crée pas ces problèmes documentaires. Elle rend leurs conséquences plus visibles.
Quand l'hétérogénéité devient un problème de confiance
L'hétérogénéité devient problématique lorsqu'elle introduit de l'incertitude dans les connaissances accessibles aux humains comme aux systèmes d'IA.
Le problème n'est pas seulement que l'information soit répartie entre plusieurs outils, formats ou contributeurs. La véritable difficulté consiste à déterminer ce que cette information signifie, dans quelle mesure elle est fiable, où elle s'applique et comment elle se relie aux autres sources.
Un système de retrieval peut retrouver un passage pertinent tout en manquant du contexte nécessaire pour déterminer quelle source doit prévaloir.
- L'information est-elle actuelle ?
- A-t-elle été relue ?
- S'agit-il d'une information vérifiée, d'une interprétation, d'une hypothèse ou d'une hypothèse de travail temporaire ?
- S'applique-t-elle à l'ensemble du produit, à une version donnée ou uniquement à un contexte particulier ?
- Fait-elle autorité, ou est-elle simplement disponible ?
Ces distinctions sont importantes, car le retrieval peut techniquement réussir alors que la réponse obtenue reste peu fiable.
Une page dont le statut de cycle de vie est incorrect peut sembler actuelle alors qu'elle ne l'est plus. Une source obsolète peut entrer en concurrence avec celle qui l'a remplacée. Un contexte manquant peut transformer une affirmation valide en généralisation trompeuse.
La hiérarchie ajoute une autre couche d'incertitude.
Différentes équipes peuvent organiser leurs espaces selon des logiques complètement différentes : produit, projet, chronologie, département, fonctionnalité, ou parfois sans structure stable.
-
Pour les humains, cela rend la navigation imprévisible et complique l'évaluation de l'exhaustivité des informations retrouvées.
-
Pour les systèmes d'IA, cela affaiblit le contexte structurel. Les relations parent-enfant, la position dans la hiérarchie et la proximité avec des informations liées peuvent ne plus fournir de signaux fiables sur le sens, le périmètre ou l'autorité.
Des schémas récurrents aux conséquences durables
Dans les grands environnements de connaissances, plusieurs schémas récurrents ont tendance à apparaître :
- connaissances incomplètes ou implicites ;
- connaissances fragmentées ;
- accumulation de strates historiques ;
- sources dupliquées ou concurrentes ;
- dérive du cycle de vie ;
- dérive terminologique ;
- structures et hiérarchies incohérentes ;
- contributeurs multiples appliquant des conventions différentes ;
- formats hétérogènes ;
- signaux de qualification faibles ou trompeurs.
Ces schémas ont des effets qui dépassent le simple retrieval.
Ils peuvent affaiblir la fiabilité du corpus, brouiller la source de vérité, déformer son périmètre effectif, fragmenter la terminologie et l'identité de l'entreprise, rendre les informations plus difficiles à catégoriser et, au final, réduire la qualité des résultats générés par l'IA.
La question suivante n'est donc pas simplement : comment nettoyer la documentation ?
Elle devient :
Quel niveau de confiance attendons-nous des connaissances que nous sommes sur le point d'exposer à l'IA ?
Définir les dimensions de confiance
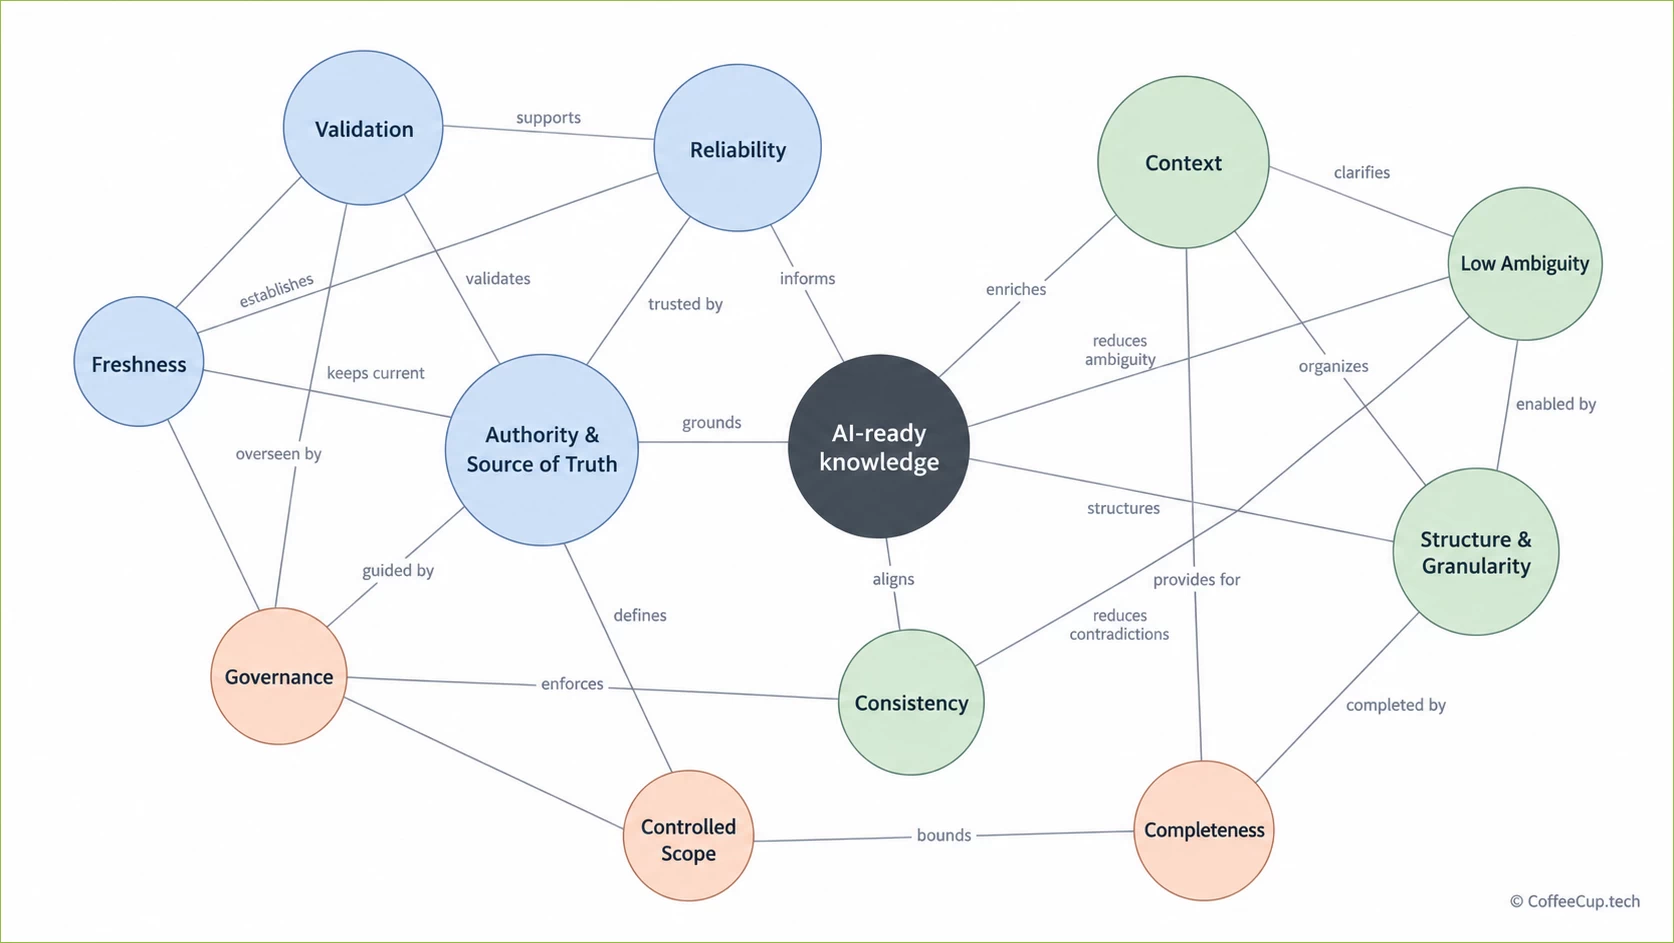
Une connaissance AI-ready n'est pas seulement du contenu. C'est du contenu plus des signaux de qualification.
C'est aussi à ce stade que le concept de docs-as-data prend tout son sens : la documentation n'est plus seulement un ensemble de pages, mais une source de connaissances dont le contenu, les métadonnées, le statut et les relations peuvent tous porter du sens pour les systèmes qui les exploitent en aval.
Avant de décider quels leviers documentaires utiliser, il est utile de définir ce qui rend une source de connaissances suffisamment digne de confiance pour alimenter des réponses générées par l'IA.
Ces qualités peuvent être considérées comme des dimensions de confiance, plutôt que comme un état binaire conforme/non conforme.
Utiliser des signaux documentaires pour rendre la connaissance AI-ready
Une fois les qualités attendues de la source de connaissances clairement définies, la documentation peut être examinée à travers les signaux déjà disponibles — ou ceux qu'il faut créer.
Identifier et qualifier les signaux de connaissance
| Levier documentaire | Ce qu'il peut exprimer |
|---|---|
| Métadonnées | Propriétaire, audience, produit, fonctionnalité, version, langue, type de contenu, dates de revue et autres informations contextuelles. |
| Statuts et signaux de cycle de vie | Indiquer si un contenu est à l'état de brouillon, relu, actif, déprécié, archivé ou encore en cours de rédaction. Ces signaux peuvent s'appuyer sur les statuts natifs de l'application, les en-têtes de page, le front matter ou d'autres mécanismes déjà pris en charge par l'environnement documentaire. |
| Historique | Comment l'information a évolué, quelles décisions ou versions ont remplacé les précédentes et comment l'état actuel se rapporte aux états antérieurs. |
| Information canonique | Quelle source doit être considérée comme faisant autorité lorsque plusieurs sources couvrent le même sujet. |
| Terminologie | Termes privilégiés, alias, acronymes, anciens noms, identifiants de code et terminologie dépréciée. Un glossaire maintenu peut rendre ces relations explicites. |
| Structure et hiérarchie | Relations entre concepts, procédures, références, fonctionnalités et pages associées, notamment les structures parent-enfant porteuses de sens. |
| Provenance | D'où vient l'information, qui l'a produite et si elle provient d'une documentation validée, d'artefacts d'implémentation, d'entretiens ou d'autres éléments de preuve. |
| Accès et confidentialité | Déterminer si une source doit être exposée ou non au service d'IA. |
| Relations entre sources | Comment les pages de documentation se relient au code, aux tickets, aux release notes ou informations de version, aux artefacts de projet et à d'autres sources de connaissances. |
L'objectif n'est pas de maximiser les métadonnées ou d'ajouter de la gouvernance pour le principe.
Chaque signal doit contribuer à réduire l'incertitude.
Une connaissance AI-ready n'est pas seulement du contenu ; c'est du contenu plus des signaux de qualification.
Exemples de signaux de qualification des connaissances
Les release notes comme source d'historique produit
Les release notes peuvent apporter davantage qu'une simple communication produit.
Lorsqu'elles sont complètes et tenues à jour, elles peuvent constituer une source chronologique fiable sur l'évolution d'une fonctionnalité : quand elle est apparue, quand son comportement a changé, quand elle a été dépréciée ou remplacée.
Ces informations historiques peuvent aider à distinguer la description actuelle d'une fonctionnalité d'une documentation qui décrivait correctement une version antérieure.
Un glossaire comme référence terminologique
La terminologie fournit un autre exemple.
Créer et maintenir un glossaire n'est pas seulement utile pour les lecteurs. Il peut documenter la terminologie privilégiée, les alias, les acronymes, les anciens noms et les relations explicites entre concepts.
Le statut du document comme signal de cycle de vie
De la même manière, les informations de cycle de vie déjà prises en charge par les outils de documentation doivent être considérées comme des signaux de connaissance utiles plutôt que comme de simples indicateurs visuels.
Une bannière deprecated, un statut de page, un champ de front matter ou une propriété d'archivage peuvent aider les humains comme les machines à comprendre qu'une information techniquement accessible ne représente plus l'état actuel.
Ces signaux ne remplacent pas le jugement éditorial.
Ils rendent ce jugement plus explicite et plus réutilisable.
Une connaissance AI-ready doit rester vivante
Rendre une documentation exploitable par un système RAG, un agent ou un chatbot ne fige pas la base de connaissances dans un état donné.
Les connaissances continuent d'évoluer.
De nouvelles informations sont créées. Les contenus existants sont révisés. Les produits changent. Les équipes se réorganisent. De nouveaux contributeurs arrivent. D'autres partent. De nouveaux outils et de nouvelles sources apparaissent. La terminologie évolue, et les frontières de l'environnement de connaissances utile se déplacent.
C'est normal.
L'objectif n'est donc pas de créer un corpus parfaitement homogène et statique avant de le connecter à l'IA.
Il s'agit de créer un environnement de connaissances capable de continuer à vivre sans perdre progressivement les qualités qui le rendent fiable et exploitable.
Cela implique de permettre aux bases de connaissances et aux corpus documentaires de croître, de coexister avec d'autres sources d'information et d'intégrer de nouvelles contributions, tout en réévaluant périodiquement les formes d'hétérogénéité et de dérive identifiées lors de l'audit initial.
Cela signifie également revenir régulièrement sur des questions telles que :
- De nouvelles lacunes dans les connaissances apparaissent-elles ?
- La terminologie commence-t-elle à diverger ?
- Des strates obsolètes s'accumulent-elles à nouveau ?
- Les statuts de cycle de vie sont-ils toujours pertinents ?
- La source de vérité a-t-elle changé ?
- Des connaissances importantes ont-elles migré ailleurs ?
- Des sources auparavant pertinentes sont-elles toujours dans le périmètre ?
La source de connaissances a donc besoin de sa propre forme d'évaluation continue.
Cela reflète le cycle de vie des services d'IA construits au-dessus d'elle.
Comme expliqué dans Agents documentaires : 3. Tester et évaluer, un agent ne doit pas être considéré comme terminé dès sa mise en production. Son comportement, son utilité et sa pertinence doivent être réévalués dans le temps, et il peut être nécessaire de l'ajuster, de le reconcevoir ou, à terme, de le retirer.
Le même principe s'applique aux connaissances sur lesquelles il repose.
Le cycle de vie d'un agent et celui d'une documentation ne sont pas deux sujets séparés. Ils s'influencent mutuellement.
-
Une modification du corpus peut altérer la qualité du retrieval.
-
Une dérive terminologique peut affecter des réponses qui fonctionnaient auparavant.
-
Une nouvelle source faisant autorité peut modifier l'ordre de priorité entre les informations.
À l'inverse, des échecs répétés de l'agent peuvent révéler des lacunes documentaires, des métadonnées insuffisantes, une terminologie ambiguë ou une gouvernance mal définie qui n'étaient pas visibles auparavant.
Cela crée une boucle de rétroaction entre la qualité de la documentation et la qualité de l'IA.
Une connaissance AI-ready n'est donc pas un corpus achevé. C'est un système de connaissances maintenu.
Rendre des connaissances existantes AI-ready consiste à améliorer leur qualité, leur structure, leur qualification et leur gouvernance tout en les gardant exploitables par les humains.
Mais cela soulève une autre question : la même représentation des connaissances doit-elle servir à la fois les humains et les machines ?
Un Documentation Twin explore l'étape suivante : dériver, à partir de la même source de connaissances gouvernée, une représentation orientée machine.
Même connaissance. Représentation différente.
© Auteur : Florence Venisse, experte en documentation technique & IA – Première version datée du 29 septembre 2026